Tessera:通过内核粒度解耦解锁异构GPU
异构GPU集群的转变
现代数据中心不再由统一的硬件组成。随着GPU代际的快速发展——NVIDIA从Ampere到Hopper再到现在的Blackwell——云服务提供商面临着“异构”集群的局面。这些环境混合了旧的、通常更经济实惠的GPU与最新的高性能单元。虽然这种异构性是多样化供应链和硬件退役周期的副产品,但它带来了显著的优化挑战:如何高效地在计算和内存能力差异巨大的芯片上运行大型语言模型(LLMs)和其他AI工作负载。

图1:单GPU正常执行与根据内核特性将其分散到异构GPU上执行的对比。
在典型设置中,像A100这样的高端GPU可能提供高内存带宽,而像L40s这样的通用GPU则提供更高的原始计算吞吐量(TFLOPS)但内存带宽较低。目前管理这些差异的策略通常依赖于“粗粒度”解耦。例如,有些系统在LLM推理中将“预填充”(prefill)阶段(计算密集型)与“解码”(decode)阶段(内存带宽密集型)分离,将每个阶段路由到符合其特定需求的GPU。然而,这些方法错过了模型实际执行路径中细粒度的优化机会。
粗粒度方法的局限性
阶段级或块级解耦的主要问题在于,它假设一个阶段内的每个操作都具有相同的资源需求。实际分析揭示了不同的情况。在一个LLM的“解码”阶段内,混合了多种内核:有些确实受内存带宽限制,但另一些则受计算限制或缓存性能限制。

图2:不同AI工作负载的分析显示,大部分执行时间花费在那些更适合不同类型GPU的内核上,而非粗粒度策略所分配的GPU
如图2所示,流行模型中相当一部分内核在“较弱”的通用GPU上运行得比在“高级”GPU上更快。例如,L40s GPU尽管更便宜,但在某些计算密集型操作(如FlashAttention)上却胜过A100。反之,A100在内存密集型操作(如cublasGemv)上表现更优。通过强迫整个阶段在一种GPU类型上运行,现有系统“错位”了许多内核,导致硬件利用率低下和次优性能。
Tessera:内核粒度解耦
Tessera是一个旨在通过在单个GPU内核级别管理工作负载来释放异构集群潜在性能的系统。内核是GPU编程中调度的基本单元。通过将内核视为工作的原子单元,Tessera可以精确地将AI模型的特定数学操作与各种GPU的架构优势对齐。
该系统的贡献在于它能够自动分析应用程序的内核依赖关系,规划跨可用硬件的最佳分布,并以最小的通信开销执行此计划。
分析与规划单元
为确保在GPU之间移动内核不会破坏模型,Tessera必须理解它们之间的数据依赖关系。它使用**内核分析器(Kernel Analyzer)**对模型的执行轨迹进行离线分析。
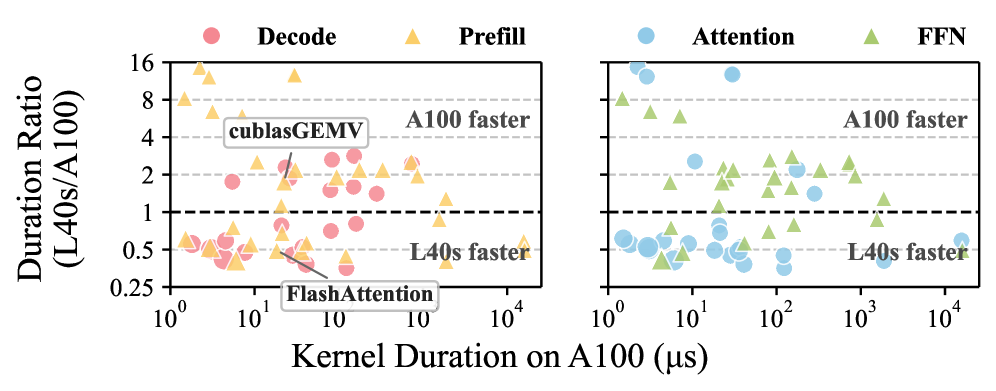
图3:Prefill、Decode、Attention和FFN块中内核的持续时间比率,展示了硬件偏好的细粒度差异。
这里的一个关键挑战是“不透明”内核——那些内存访问模式未公开(如专有库中的内核)的内核。Tessera通过分析并行线程执行(PTX)代码来解决这个问题。它对PTX进行插桩,以记录在试运行期间访问的精确内存地址。这使得系统无需每个内核的源代码即可构建精确的数据依赖图(DDG)。
一旦已知依赖关系,策略规划器将调度问题表述为一个混合整数线性规划(MILP)任务。其目标是最小化集群中“瓶颈”阶段的时间。如果我们将GPU g 上的总工作量表示为 W_g,则目标是最小化最大 W_g。工作量包括计算时间 T_g 和通信时间 M_g:

计算时间 T_g 是分配给该GPU的每个内核 k 的延迟 t_{k,g} 之和(由二进制变量 x_{k,g} 表示): 
通信开销 M_g 是根据分配给不同GPU u 和 g 的内核之间传输的数据量计算的:

其中 size_{i,j} 是数据量,bw_{u,g} 是GPU之间的带宽,\ell_{u,g} 是固定的延迟开销。
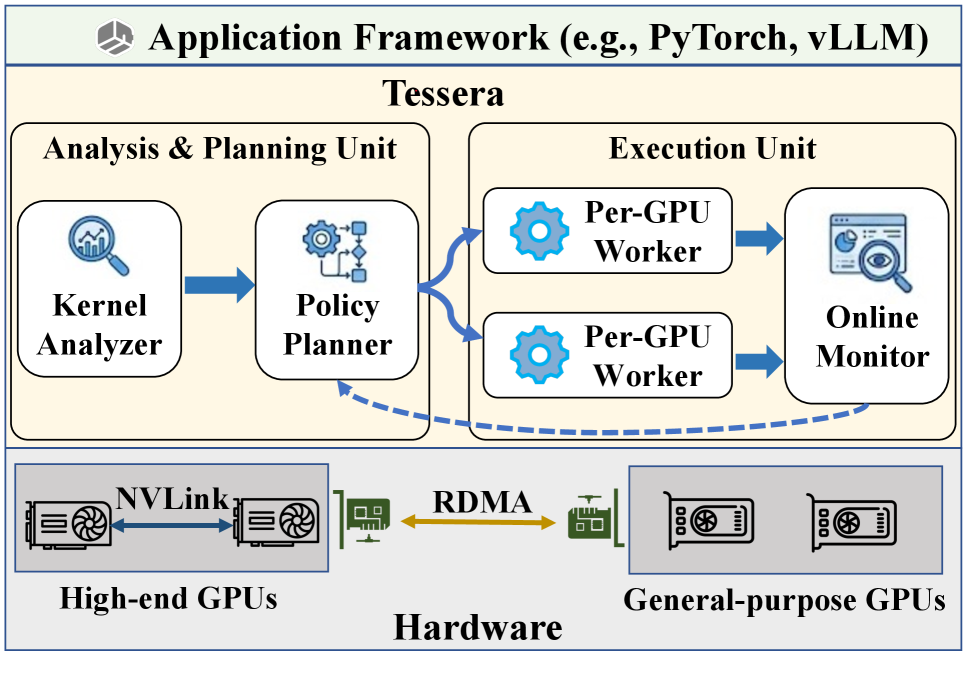
图4:Tessera的整体架构,突出显示了离线分析阶段和在线执行单元。
克服通信开销
将模型拆分到多个GPU上会带来网络成为瓶颈的风险。Tessera采用多种技术来确保GPU在数据传输时保持忙碌:
- 流水线执行: 当一个请求在GPU A上计算时,另一个请求的数据正在传输到GPU B。这“掩盖”了通信时间。
- GPU发起通信: Tessera使用InfiniBand GPUDirect Async (IBGDA) 和 NCCL,而不是等待CPU协调数据传输。这允许GPU上的内核触发自己的数据发送和接收,减少了同步延迟。
- 优先级感知调度: 为了防止由于共享网络链接而导致多个请求同时停滞,Tessera为较旧的请求分配更高的优先级。这错开了它们的通信阶段,确保在任何给定时刻,大多数GPU都在进行有效的计算,而不是等待网络。
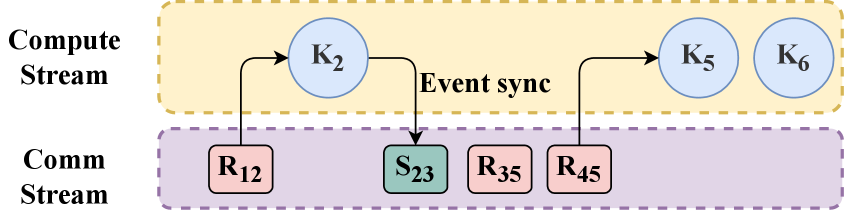
图5:重叠计算和通信流以最大化GPU利用率。
实验性能和效率
研究人员使用A100+L40s和H100+RTX Pro 6000等各种GPU对,对Tessera在Llama-3 (LLM)、Mamba (状态空间模型) 和Stable Diffusion (图像生成) 等多个要求严苛的模型上进行了评估。
吞吐量增益
与Prefill-Decode (PD) 解聚相比,Tessera实现了平均1.5倍的吞吐量提升,比Attention-FFN (AF) 解聚高出1.35倍。值得注意的是,Tessera是唯一能够处理Mamba和Stable Diffusion模型的系统,因为它不依赖于PD和AF方法所需的特定“Attention”或“Transformer”结构。
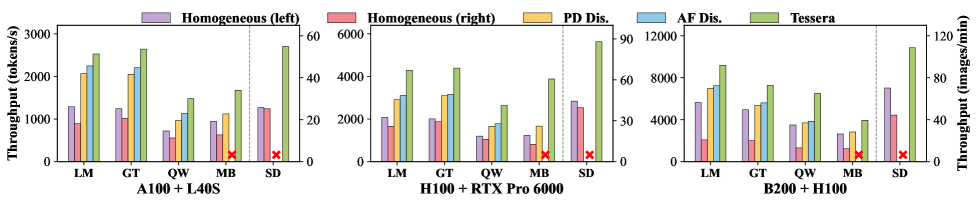 图6:不同模型和GPU对的吞吐量比较,显示Tessera始终保持性能领先。
成本效率 (性能/$)
最引人注目的结果之一是成本效益。评估发现,异构配对——例如H100与便宜得多的RTX Pro 6000配对——实际上可以提供比单个H100高2.3倍的吞吐量。这种配置实现了独立H100的1.64倍成本效率,证明混合使用高端和经济型GPU可以优于单独使用高端硬件。
服务在线请求
对于实时应用,延迟与吞吐量同样重要。Tessera包含一个在线监控器,用于检测服务器何时处于高负载状态。当请求延迟L_{req}与执行时间L_{exec}的比率超过阈值\beta时:

系统会自动从延迟优化策略(最小化单个请求的总延迟)切换到吞吐量优化策略(最大化完成请求的速率)。这种自适应能力使Tessera能够支持比现有方法高1.3倍的请求速率,同时仍能满足严格的服务水平目标 (SLO)。
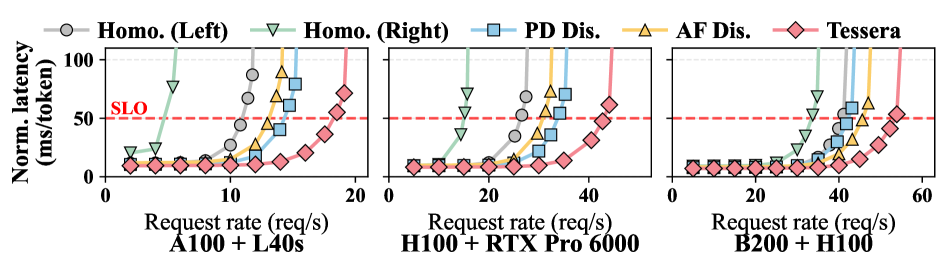
图7:归一化延迟作为请求速率的函数。即使系统接近高负载,Tessera也能保持较低的延迟。
可伸缩性和鲁棒性
Tessera也能很好地扩展到更大的集群。在16个GPU(8个B200和8个H100)的测试中,它保持了性能优势,比次优方法高1.4倍。这证实了内核级方法与张量并行等标准模型并行技术兼容。
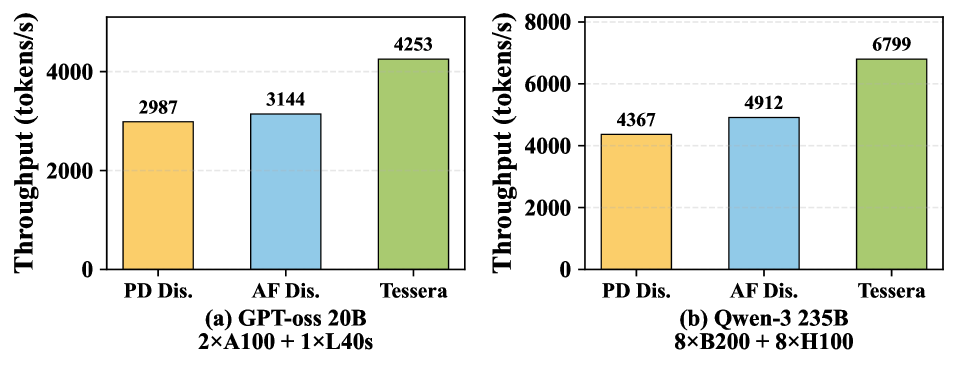
图8:多GPU集群上的性能,表明Tessera的优势可扩展到更大规模的部署。
此外,该系统对网络条件具有出人意料的鲁棒性。即使网络带宽从200 Gbps限制到25 Gbps,Tessera的吞吐量下降也小于6%。这是优先级感知流水线的直接结果,它有效地隐藏了增加的数据传输时间。
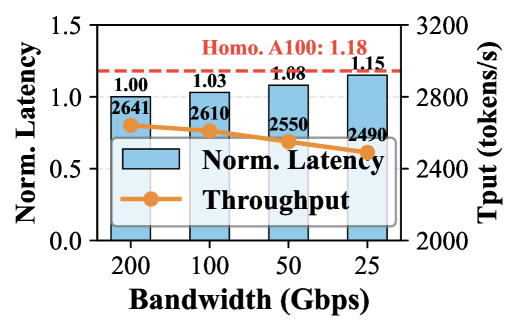
图11:网络带宽对性能的影响。流水线技术使得Tessera即使在较慢的网络连接下也能保持高效。
结论
Tessera代表了我们看待硬件异构性方式的转变。Tessera没有将不同代GPU的混合视为管理负担,而是将其视为一个优化机会。通过将调度粒度从高级模型阶段下移到单个GPU内核,它使AI应用能够从集群中的每个芯片中榨取最大的可能性能。
该系统能够处理多样化的模型架构——不仅仅是Transformer——以及在成本效率方面的显著提升,使其成为现代AI基础设施的实用解决方案。随着行业不断生产在计算、内存和价格方面具有不同权衡的GPU,Tessera等系统可能对于构建可持续高性能的AI服务至关重要。
DistServe: 分离预填充与解码,优化大语言模型服务的有效吞吐量
本文介绍了一个最先进的阶段级分解系统,该系统分离了LLM推理的预填充和解码阶段。Tessera明确地使用这项工作作为主要基线(简称“PD Dis.”),以展示这种粗粒度方法的性能局限性,从而促使其自身更细粒度的、内核级的解决方案。
Y. Zhong, S. Liu, J. Chen, J. Hu, Y. Zhu, X. Liu, X. Jin, and H. Zhang, “DistServe: Disaggregating prefill and decoding for goodput-optimized large language model serving,” in 18th USENIX Symposium on Operating Systems Design and Implementation (OSDI 24). [Online]. Available: https://www.usenix.org/conference/osdi24/presentation/zhon g-yinmin
超大规模推理:基于解耦专家并行的高效专家混合模型服务
本工作引入了一种块级分解方法,该方法将注意力(Attention)和前馈网络(FFN)操作映射到不同的GPU。Tessera 将其识别为另一种粗粒度分解形式,并将其作为一个关键基线(“AF 分解”)来突出架构特定方法的次优性和有限的通用性,这进一步强调了 Tessera 模型无关的内核级策略的必要性。
R. Zhu, Z. Jiang, C. Jin, P. Wu, C. A. Stuardo, D. Wang, X. Zhang, H. Zhou, H. Wei, Y. Cheng, J. Xiao, X. Zhang, L. Liu, H. Lin, L.-W. Chang, J. Ye, X. Yu, X. Liu, X. Jin, and X. Liu, “Megascale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism,” in Proceedings of the 39th ACM Special Interest Group on Data Communication (SIGCOMM 25). [Online]. Available: https://doi.org/10.1145/3718958.3750506
斯普利特怀斯:采用相位分割实现高效生成式LLM推理
Splitwise 是一项解耦 LLM 推理的奠基性工作,它通过分离计算密集型预填充阶段和内存密集型解码阶段来实现。Tessera 论文频繁引用 Splitwise,以确立现有解耦技术的背景,并指出这种阶段级粒度不足以充分利用硬件异构性,从而为 Tessera 自身的内核级方法奠定基础。